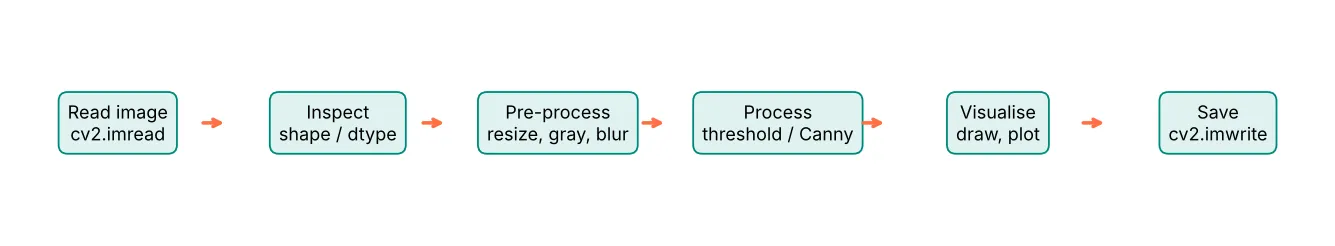
Text preprocessing adalah tahapan awal sebelum data teks dipakai buat analisis NLP (Natural Language Processing) kayak sentiment analysis, topic modeling, atau text classification.
Di artikel ini ogut bakal bikin 1 program dari Python buat load data dari csv sampe N-Grams.
Get Dicki Haris Sujadi’s stories in your inbox
Join Medium for free to get updates from this writer.
Apa itu N-Grams? N-Grams adalah urutan n item yang berdekatan dalam sebuah teks, yang bisa berupa kata, karakter, atau simbol. Tujuannya buat nangkep konteks kata.
Unigram → 1 kata
Bigram → 2 kata (misal: “not good”)
Trigram → 3 kata
Gambaran besar program text preprocessing kita nanti kaya gini:
Press enter or click to view image in full size
Data masuk → di-lowercase → dibersihkan dari stopword & tanda baca (punctuation).
Setelah bersih → ditokenisasi.
Hasil token bisa lewat dua jalur: Stemming, Lemmatization
Akhirnya hasil bersih dipakai buat bikin N-Grams.
Download dulu file csv-nya disini. Setelah ke-download, tempatin file-nya jadi satu tempat di program file Python klean ya.
# import modul-modul yang dibutuhin # nltk : NLP toolkit # word_tokenize: Pisah teks jadi kata # PorterStemmer: Ubah kata ke bentuk dasar kasar # WordNetLemmatizer: Ubah kata ke bentuk dasar yang valid # stopwords: List kata umum yang dihapus, contoh: "the", "is", "at" # re: Regex buat bersihin teks # pandas: Olah teks dalam tabel, hasilnya bakal disimpan ke DataFrame import nltk from nltk.tokenize import word_tokenize from nltk.stem import PorterStemmer, WordNetLemmatizer from nltk.corpus import stopwords nltk.download('stopwords') nltk.download('punkt') nltk.download('punkt_tab') nltk.download('wordnet') import re import pandas as pd
# load data data = pd.read_csv("restaurant_reviews.csv") # lihat info data data.info() # lihat isi data data.head() # lihat data di kolom 'Review', baris pertama `[0]` data["Review"][0]
# convert ke lowercase data['review_lowercase'] = data['Review'].str.lower() data.head()
# refer ke stopwords list (yang bakal di-remove) en_stopwords = stopwords.words('english') en_stopwords.remove('not')
# remove stopwords dari text based on en_stopwords data['review_no_stopwords'] = data['review_lowercase'].apply(lambda x: ' '.join([word for word in x.split() if word not in (en_stopwords)]))
# tokenize => pecah text per kata(token). # hasilnya bakal disimpan ke list # `axis = 1` => operasinya dilakuin satu persatu data['tokenized'] = data.apply(lambda x: word_tokenize(x['review_no_stopwords_no_punct']), axis = 1) # cek hasil, satu aja gausah banyak2 🙂 data['tokenized'][0]
# PorterStemmer ini buat stemming, contoh: `eating` jadi `eat` ps = PorterStemmer() data['stemmed'] = data['tokenized'].apply(lambda tokens: [ps.stem(token) for token in tokens]) # cek hasil data.head()
# WordNetLemmatizer : buat Lemmatized, contoh `better` jadi `good` lemmatizer = WordNetLemmatizer() data['lemmatized'] = data['tokenized'].apply(lambda tokens: [lemmatizer.lemmatize(token) for token in tokens]) # cek hasil, satu aja gausah banyak2 🙂 data['lemmatized'][0] # nge-gabung-in semua list token menjadi satu list besar tokens_clean = sum(data['lemmatized'], [])