Towards a Human-like Open-Domain Chatbot

Google는 2020년에 챗봇을 위한 Metric인 SSA(Sensibleness andSpecificity Average)을 공개했습니다. 이 Metric는 2022년에는 확장되어 LaMDA 2 모델의 학습에 사용되었습니다.
이번 포스트에서는 LaMDA의 이전 모델인 Meena와 Meena의 학습에 활용되었던 SSA 평가 Metric를 논문을 기반으로 정리합니다.
Meena는 End-to-end의 Generation 모델로 다른 모델과 같이 여러 모델로 구성되어 있거나 Closed-domain이 아닌 Single leanring, open domain 모델로 당시의 다른 모델에 비해 높은 수준의 대화를 구현하고 인간과 비슷한 수준의 챗봇 성능을 보여주어 화제가 되었습니다.
Motivation
기존의 챗봇은 활용 데이터의 영역, 학습/모델 구조에 따라 나눌 수 있습니다.
Closed domain vs. Open domain
Closed domain: Keyword, Intent를 기반으로 대화를 수행하며 학습된 데이터가 속하는 특정 Task에 대한 역할 수행 능력이 좋다.
Open domain: 일상 채팅과 같은 특정 domain에 속하지 않은 대화를 수행하기 좋으며 다양한 영역의 대화를 진행할 수 있다.
특정 영역/목적에 맞게 학습시키는 Closed domain chatbot은 해당 영역에서는 좋은 성능을 보여주지만 일반적인 대화, 다양한 주제를 활용하기에는 어렵습니다.
End-to-End Model vs. Complex Model
End-to-End Model: 심플한 단일 Model, 학습 데이터, 학습 효율, Domain등 다양한 문제가 존재
Complex Model: 챗봇의 각 영역에 해당되는 부분을 각각의 모델로 구성하는 것. Intent 분류, Dialog Maneger, Rule 등 다양한 역할을 하는 모델들이 각각의 기능을 수행해 챗봇을 수행
기존, 대부분의 챗봇은 Complex Model로 구성되어 의도를 파악하거나 출력해야하는 대화에 대한 방향이나 문장 생성을 각각의 모델이 작용해 챗봇을 구성합니다. 하지만 모델 자체가 복잡하고 학습량이 상당히 많습니다.
Google research 팀은 Open-domain과 End-to-End 모델인 Meena를 공개하면서 챗봇 평가 Metric를 공개하여 현재까지도 활용하고 있습니다.
Get Kanghee Lee’s stories in your inbox
Join Medium for free to get updates from this writer.
SSA(Sensibleness andSpecificity Average)
Meena에서 사용된 챗봇 평가 Metric는 SSA로 챗봇의 대화가 Sensible한지 그리고 Specificity를 평가합니다.
Sensible은 답변이 대화 컨텍스트에 맞는지, 전에 말했던 것과 모순되지 않는지를 이진 분류를 통해 평가
Specificity는 답변이 두루뭉실하거나 일반적이지 않고, 대화 컨텍스트에 구체적인 답변인가를 이진 분류를 통해 평가
Meena
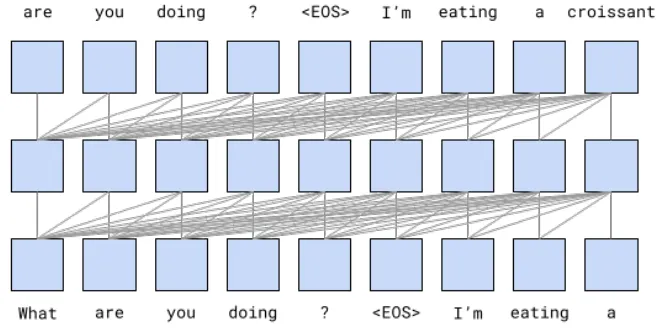
Meena는 1 ET(Evolved Transformer) Encoder + 13 ET Decoder로 구성되어 있다.

위의 그림과 같이 퍼블릭 도메인의 소셜 미디어 대화 데이터이며 최대 7 턴의 대화가 포함되어 있는 대화 데이터를 입력 데이터로 활용합니다.
평가 지표는 Perplexity로 이전 단어로 다음 단어를 예측할 때 몇 개의 단어 후보를 고려하는지를 의미합니다. 여기서 고려해야 할 단어 후보가 많다는 것은 그 만큼 언어 모델이 쉽게 정답을 못 내고 있다고 해석할 수 있습니다. Perplexity는 아래의 식을 따라 계산합니다.

결과
- Meena의 SSA 성능은 79%로 사람의 SSA(86%)보다는 낮지만 기존의 챗봇 보다는 최소 23% 이상 차이점을 보여주고 있습니다.
2. Perlexity와 SSA 점수는 높은 상관관계를 가지고 있습니다. (= Perlexity를 낮춘다면 SSA도 올라갑니다.)
Meena 대화 예시