WPC (WordPiece) Tokenizasyon Algoritması

Bölüm 1 : Tokenizasyon (Belirteçleme) Üzerine Derinlemesine Bir Analiz
Bölüm 2 : BPE (Byte-Pear Encoding) Tokenizasyon Algoritması
Bölüm 3 : WPC (WordPiece) Tokenizasyon Algoritması
Bölüm 4 : Unigram Tokenizasyon Algoritması
Bölüm 5 : Adım Adım Özel Bir Tokenizer Oluşturma (Uygulama)
Yazı dizisinin üçüncü bölümünde sizlerle tekrar buluşmaktan mutluluk duyuyorum. Bölüm 2'yi kısaca hatırlayalım. Bölüm 2'de BPE (Byte-Pear Encoding) algoritmasından bahsetmiştik. BPE algoritmasının öne çıkan özelliklerini ve çalışma mekanizmasını detaylıca incelemiştik. Gerek pure code ile gerekse de Transformers kütüphanesini kullanarak BPE algoritmasını uygulamıştık. Şimdi benzer bir algoritma olan ve Google’ın BERT’i eğitmek için geliştirdiği WPC (WordPiece) tokenizasyon algoritmasını inceleyelim.

WPC (WordPiece) Algoritması
Yukarıda ifade ettiğim gibi WordPiece, Google’ın BERT’i eğitmek için geliştirdiği tokenizasyon algoritmasıdır. İlk çıktığı günden bu yana DistilBERT, MobileBERT, Funnel Transformers ve MPNET gibi BERT’i temel alan pek çok Transformer modelinde sıklıkla kullanıldı. WordPiece eğitim açısından BPE’ye oldukça benzer olsa da kelimelerin tokenize edilmesi aşamasında daha farklı bir teknik kullanır. Burada algoritmayı basit şekilde anlatan bir video mevcut; tavsiye ederim.
Google, WordPiece’in eğitim algoritmasının uygulanmasını hiçbir zaman açık kaynaklı hale getirmedi, bu nedenle internette dolaşan tüm bilgiler tamamen varsayımlara dayalıdır ve yüzde yüz doğruluk içermez. Burada ki çalışmamızı da bu bağlamda değerlendirmenizi rica ediyorum. Birgün Google WPC algoritmasını açık kaynak haline getirilirse (ki sanmıyorum) en doğrusunu o zaman görebileceğiz.
WordPiece, alt kelime tabanlı bir tokenizasyon algoritmasıdır. İlk kez “ Japonca ve Korece Sesli Arama (Schuster ve diğerleri, 2012) ” makalesinde ortaya çıkmıştır. Popülerlik kazanmasını ise BERT’e borçludur. Yapısal olarak BPE’den çok farklı değildir. Bu nedenle devam etmeden önce Bölüm 2 yi okuyarak BPE’nin çalışma mantığını anlamanızı tavsiye ederim.
WordPiece, tek bir kelimeyi simgeleştirmek için en uzun eşleşme stratejisini kullanır. Bu yaklaşım maksimum eşleştirme veya MaxMatch olarak bilinir ve 1980 lerden bu yana Çince kelime bölümlemesi için sıklıkla kullanılır. Burada, google yapay zeka ekibinin paylaştığı derinlemesine bilgiler mevcut. Göz atmak isteyebilirsiniz.
WordPiece algoritması, kelimeleri tek tek karakterlere bölerek ve daha büyük bir kelimenin parçası olduğunu belirtmek için her kelimenin başına genellikle “##” gibi özel bir sembol ekleyerek işleme başlar. Daha sonra eğitim külliyatına dayalı olarak alt kelime birimlerinden oluşan bir kelime dağarcığı oluşturur. Tokenizasyon sırasında WordPiece, kelimeleri alt kelime birimlerine ayırır ve onlara benzersiz kimlikler atar. Bu süreç, hem bireysel karakterlerin ayrıntı düzeyini hem de daha büyük kelimelerin bağlamını yakalamaya yardımcı olur.
Örneğin, "dünya" kelimesi bu algoritma ile şu şekilde bölünür:
d ##ü ##n ##y ##aAlgoritma daha kelime birleşimlerinin sıklığını olasılıksal olarak dikkate alır ve yeni Kelime Parçaları oluşturmak için en sık rastlanan karakter veya simge çiftlerini yinelemeli olarak birleştirir .
Daha sonra kelime dağarcığı oluşturulur. İki şekilde uygulanır:
- Aşağıdan yukarıya (BPE’ye temeline dayanır)
- Yukarıdan aşağıya
BPE Varken Neden WordPiece ?
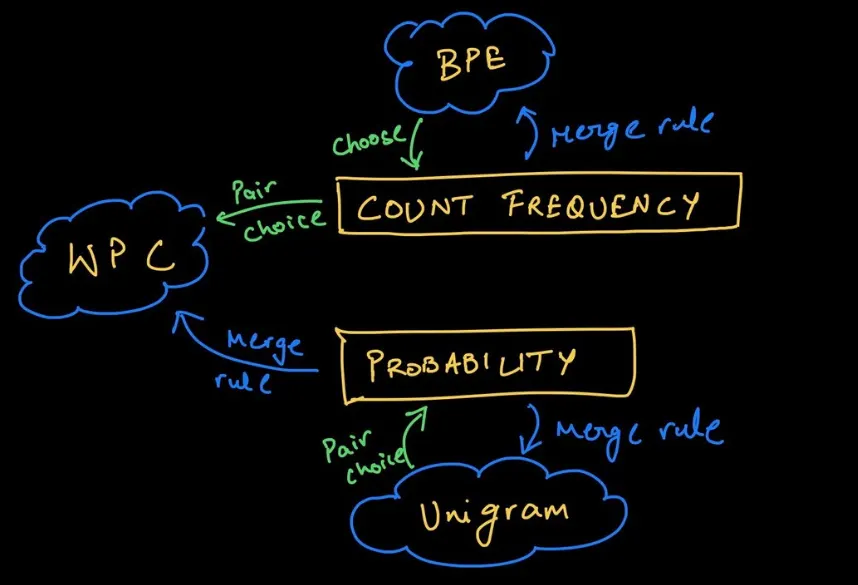
BPE bir çift token alır ve her bir çiftin frekansına bakar. En yüksek birleşik frekansa sahip olan çifti birleştirir. Süreç, her adımda en yüksek birleşik frekansı arar. Oysa ki belirli bir kelimeyi kodlamanın birden fazla yolunun olduğu durumlar olabilir. Hangisinin önce kullanılacağına öncelik vermenin net bir yolu olmadığından, algoritmanın alt kelime simgelerini seçmesi zorlaşır. Dolayısıyla aynı girdi, öğrenilen gösterimlerin doğruluğunu etkileyen farklı kodlamalarla temsil edilebilir.

Örneğin yukarıda ki gibi bir kelime dağarcığımız olduğunu düşünelim. Ve örneklem olarak “oğuzhan” ve “yenen” kelimelerini ele alalım. Bu kelimeleri şu şekilde tokenize edebilir miyiz?
oğuzhan = o + ğu + z + h + a + n veya o + ğu + uzh + an
yenen = y + en + e + n veya y + ene + n
Verilen ifadedeki her bir kelimeyi simgeleştirmenin iki farklı yolu olduğunu görebiliriz; bu ifadeyi simgeleştirmenin toplam dört yolunu gösterir. Yani aynı girişe sahip olan metin dört farklı şekilde kodlanabilir. Bu gerçekten büyük bir sorundur.
Hatırlarsanız bir önceki bölümde BPE’nin simge çiftinin frekansını hesaba katarak tokenizasyon işlemini yaptığını söylemiştik. Peki, BPE’nin bu frekans yaklaşımından daha iyi performans gösterecek bir algoritmayı nasıl kurabiliriz? Google Yapay Zeka ekibinin araştırmaları sonucunda şöyle bir düşünce gelişmiştir: Belirli bir sembol çifti birleştirilirken her adımda sahip olduğu etkiyi hesaba katmak çok daha iyi performans sergileyebilecektir.
Bu yeni düşünce yaklaşımı bizi frekansın bir adım ötesine, olasılıksal yaklaşımlara götürür. WordPiece’de aslında bunu yapar. WordPiece ve BPE arasındaki temel fark, algoritmaların sembol çiftlerinin sözlüğe ekleme biçimidir. WordPiece her yineleme adımında olasılıksal olarak en iyi performans gösterecek sembol çiftini seçer.
Bu durumu şu şekilde örnekleye biliriz: “ka” harfinin oluşma olasılığının “k” ve ardından “a” harfinin ortaya çıkma olasılığından daha fazla olup olmadığı kontrol edilir. Birleştirme “ka”nın “k”ya ve “a”ya bölünmesinin olasılığın diğer sembol çiftlerinden daha büyük olması durumunda gerçekleşir.
WPC (WordPiece) algoritması nasıl çalışır?
WordPiece algoritması, dildeki tüm karakterleri içeren bir kelime birimi envanterini ile başlar. Daha sonra bu envanter kullanılarak bir dil modeli oluşturulur ve bu, algoritmanın sözcük dağarcığında en sık görülen sembol kombinasyonlarını tanımasına olanak tanır. Bu sık kullanılan kombinasyonlar, modele eklendiğinde eğitim verilerinin olasılığını en fazla artıran yeni kelime birimini seçen yinelemeli bir süreç aracılığıyla kelime dağarcığına eklenir.
Bu sürecin sonucunda dildeki kelimeleri temsil etmek için kullanılabilecek bir dizi alt kelime elde edilir. WordPiece algoritması, sözcükleri daha küçük, daha yönetilebilir alt sözcüklere bölerek, doğal dil işlemede ki nadir sözcüklerle ve diğer zorlu dil sorunlarıyla etkili bir şekilde başa çıkar.
Yukarıda da ifade ettiğimiz gibi WPC yinelemeli bir algoritmadır ve makaleye göre algoritmanın çalışma adımları aşağıdaki gibidir:
- 1. Adım, Başlatma: Bu ilk adımda kelimelerden oluşan sözlük başlatılır. Metindeki tüm karakterlerle buna dahildir (harfler, sayılar ve özel karakterler)
- 2. Adım, Eğitim: Kelime sözlüğü kullanılarak eğitim verileri üzerine bir dil modeli oluşturulur.
- 3. Adım, Sembol Üretimi: Algoritma, mevcut kelime envanterinden iki birimi birleştirerek yeni bir alt kelime oluşturur. Yeni alt kelime, modele eklendiğinde eğitim verileri üzerinde olasılığını en fazla artıran olası alt kelimeler arasından seçilir.
- 4. Adım, Tekrar: İkinci adımdan itibaren süreci, önceden tanımlanmış bir alt kelime sınırına ulaşılana veya olasılık artışı belirli bir eşiğin altına düşene kadar tekrarlanır.
Algoritmanın üçüncü adımı, BPE ile farklılığın çıktığı adımdır. Daha önce de bahsettiğimiz gibi iki algoritma arasındaki temel fark alt kelime oluşturma noktasındadır. BPE bir alt kelimeyi sözlüğe eklerken sözcüğün frekansını hesaba katarken WPC, en yüksek olasılığa sahip sözcük çiftini seçer.
Bölüm 2 de BPE için yaptığımız gibi algoritmayı bir örnek üzerinde açıklamak gerekirse işlem adımları şu şekilde olacaktır:
- İlk adımda eğitim verisinden her kelimenin sıklığını çıkararak işleme başlıyoruz.
örnek külliyat
(“tay”, 3),(“bar”, 5), (“ray”, 4), (“tayt”, 2)
her kelimeyi simge haline dönüştürelim
(“t”,”##a”,”##y”, 3),(“b”,”##a,”##r”, 5), (“r”,”##a”,”##y”, 4), (“t”,”##a”,”##y”,”##t”, 2) - İkinci adımda en sık tekrarlanan bitişik sembol çiftlerini buluyoruz.
En sık görülen çift("##a", "##y")##a 14 nın ##y nin 9 bireysel sıklığı olsa da"##a"yüksek olduğundan puanı en yüksek değildir. Olasılıksal olarak “a” (1/14) “y” (1/9) olduğundan en iyi puan 1/9'da olur ve öğrenilen ilk birleştirme("##y", "##t") -> ("##yt")olur.
(“t”,”##a”,”##y”, 3),(“b”,”##a,”##r”, 5), (“r”,”##a”,”##y”, 4), (“t”,”##a”,”##yt”, 2) - Üçüncü adım. Bu noktada “##a” tüm olası çiftlerde yer alır, dolayısıyla hepsi aynı puana sahip olur. Diyelim ki bu durumda ilk çift birleştirilirse, yani (“t”, “##a”) -> “ta” şeklinde birleştirme sağlanırsa yeni oluşum:
(“ta”,”##y”, 3),(“b”,”##a,”##r”, 5), (“r”,”##a”,”##y”, 4), (“ta”,”##yt”, 2) - Dördüncü adım. Daha sonra bir sonraki en iyi skor (“ta”, “##y”) ve (“ta”, “##yt”) tarafından paylaşılır (diğer tüm çiftler için 1/9'a kıyasla 1/5 ile). En yüksek puana sahip ilk çift birleştirildiğinde yeni durum:
(“tay”, 3),(“b”,”##a,”##r”, 5), (“r”,”##a”,”##y”, 4), (“tayt”, 2) - Son adımda ise bu işlemi belirtilen K yineleme sayısına ulaşana veya durmaya karar verene kadar tekrar ediyoruz.
WordPiece algoritması, kelimeyi tokenize etmeye başlayarak, sözlükteki en uzun alt kelimeyi bulur ve onu böler. Yukarıdaki örnekte ki kelime dağarcığını kullanırsak "tayt"kelimesi için "tay"en uzun alt kelime olduğu için bölünme oradan başlar ve ["tay", "##t"]elde edilir; yani "tayt"ın tokenizasyonu ["tay", "##t"]şeklinde olacaktır.
Eğer bu örnek BPE için uygulansaydı öğrenilen birleştirmeleri sırasıyla uygulayıp bunu tokenize ederdik ["ta", "##yt"], dolayısıyla kodlama farklı olur.
WordPiece Algoritmasını Önemli Kılan Nedir?
WordPiece algoritması, alt kelimeleri yakalamada oldukça başarılıdır. Bir dilde ki nadir kelimelerle ve o dilin yapısal zorlukları ile etkili bir şekilde başa çıkabilir. Bu özellikleri onu dil işleme görevleri için oldukça popüler bir algoritma haline getirmiştir.
Onu önemli kılan belli başlı özellikleri ise:
- Herhangi bir dilden bağımsız olması sebebiyle çeşitli diller için uygulanabilmesi
- Alt kelime belirteçlerinin ayrıntı düzeyi, modellerin morfolojik farklılıkları yakalamasına, alan dışı terimleri ele almasına ve yeni kelimelere daha iyi genelleme yapmasına olanak tanır.
- Doğal dil işlemedeki bir diğer zorluk da sözcük dışı (OOV, eğitim verilerinde bulunmayan kelimeler) kelimelerle uğraşmaktır.
WordPiece algoritması, kelimeleri alt kelimelere bölerek, OOV kelimelerinin anlamını, bunları bilinen alt kelimelerin bir kombinasyonu olarak temsil ederek etkili bir şekilde yakalayabilir.
WordPiece algoritmasının çeşitli doğal dil işleme algoritmaları için aranan bir algoritma olduğunu söylemiştik. Şimdi kısaca hangi tür problemlerin çözümünde etkin olduğuna bakalım.
Makine Çevirisi: WordPiece, farklı dillerdeki bilinmeyen veya nadir sözcükleri etkili bir şekilde işleyerek çeviri kalitesinin artırılmasına yardımcı olur.
Get Oğuzhan Yenen’s stories in your inbox
Join Medium for free to get updates from this writer.
Adlandırılmış Varlık Tanıma: Alt kelime belirleme, varyasyonlar ve yazım hataları olsa bile kişi adları, konumlar ve kuruluşlar gibi adlandırılmış varlıkların doğru bir şekilde tanımlanmasına ve sınıflandırılmasına yardımcı olur.
Metin Sınıflandırma: WordPiece, kelimeleri etkili bir şekilde kodlayarak ve anlamsal benzerlikleri yakalayarak metin sınıflandırma modellerinin performansını artırır.
Metin Üretimi: Alt kelime belirleme, dil modellerinin, kelimeleri anlamlı alt kelime birimlerine bölerek tutarlı ve bağlamsal olarak uygun metinler üretmesine olanak tanır.
Buraya kadar WordPiece algoritmasının ne olduğunu, nasıl çalıştığını, BPE algoritmasına göre farklılığını ve kullanım alanlarını inceledik. Artık Transformers kütüphanesi kullanarak bir örnek gerçekleştirebiliriz.
Transformers kütüphanesi ile WPC tokenizer oluşturma
Burada adım adım gerçekleştireceğimiz uygulama örneği Hugging Face dökümanlarından alınarak geliştirilmiştir.
1- Adım: Kelime dağarcığını tanımlayalım
Bu aşamada işlemi basit tutmak adına üç dört cümleden oluşan bir corpus tanımlayalım.
corpus= [
     "Bu bir bpe uygulamasidir." ,
     "Bu bolum tokenizasyonla ilgilidir." ,
     "Bu bolumde bpe tokenizer algoritmasi gosterilmektedir." ,
     "Umarim onlarin nasil egitildigini anlayabilir ve token uretebilirsiniz." ,
]
2- Adım: Tokenizer modelini yükle ve kelimelerin frekanslarını hesapla
Bu aşamada öncelikle AutoTokenizer sınıfı ile “bert-base-cased” modelini yüklüyoruz ve frekansları hesaplaması için bir metod hazırlıyoruz.
from transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained("bert-base-cased")
from collections import defaultdict
word_freqs = defaultdict(int)
for text in corpus:
words_with_offsets = tokenizer.backend_tokenizer.pre_tokenizer.pre_tokenize_str(text)
new_words = [word for word, offset in words_with_offsets]
for word in new_words:
word_freqs[word] += 1
word_freqs
"""
Çıktı:
defaultdict(<class 'int'>, {'Bu': 3, 'bir': 1, 'bpe': 2, 'uygulamasidir': 1, '.': 4, 'bolum': 1, 'tokenizasyonla': 1, 'ilgilidir': 1, 'bolumde': 1, 'tokenizer': 1, 'algoritmasi': 1, 'gosterilmektedir': 1, 'Umarim': 1, 'onlarin': 1, 'nasil': 1, 'egitildigini': 1, 'anlayabilir': 1, 've': 1, 'token': 1, 'uretebilirsiniz': 1})
"""3- Adım: Corpus içinde ki karakterlerden kelime dağarcığını hesapla
alphabet = []
for word in word_freqs.keys():
    if word[0] not in alphabet:
        alphabet.append(word[0])
    for letter in word[1:]:
        if f"##{letter}" not in alphabet:
            alphabet.append(f"##{letter}")

alphabet.sort()
alphabet

print(alphabet)

"""
Çıktı:
['##a', '##b', '##d', '##e', '##g', '##i', '##k', '##l', '##m', '##n', '##o', '##p', '##r', '##s', '##t', '##u', '##y', '##z', '.', 'B', 'U', 'a', 'b', 'e', 'g', 'i', 'n', 'o', 't', 'u', 'v']
"""
Bu arada modelin kullandığı özel belirteçleri sözlüğün başına eklemeyi unutmamalıyız. BERT modeli için kullanılan tek özel belirteçler “[PAD]”, “[UNK]”, “[CLS]”, “[SEP]”, “[MASK]” dir.
vocab = ["[PAD]", "[UNK]", "[CLS]", "[SEP]", "[MASK]"] + alphabet.copy()Eğitime başlamadan önce her kelimeyi ayrı ayrı karakterlere ayırmamız gerekiyor.
splits = {
    word: [c if i == 0 else f"##{c}" for i, c in enumerate(word)]
    for word in word_freqs.keys()
}
4- Adım: Çift semboller için frekansı hesapla
Artık eğitime hazır olduğumuza göre her çift sembol için frekansı hesaplayan bir fonksiyon yazalım. Bunu eğitimin her adımında kullanmamız gerekecek:
def compute_pair_scores(splits):
    letter_freqs = defaultdict(int)
    pair_freqs = defaultdict(int)
    for word, freq in word_freqs.items():
        split = splits[word]
        if len(split) == 1:
            letter_freqs[split[0]] += freq
            continue
        for i in range(len(split) - 1):
            pair = (split[i], split[i + 1])
            letter_freqs[split[i]] += freq
            pair_freqs[pair] += freq
        letter_freqs[split[-1]] += freq

    scores = {
        pair: freq / (letter_freqs[pair[0]] * letter_freqs[pair[1]])
        for pair, freq in pair_freqs.items()
    }
    return scores
Artık en sık görülen sembol çiftini bulabiliriz. Bunun için basit bir döngü yazalım ve sonucuna bakalım:
best_pair = ""
max_score = None
for pair, score in pair_scores.items():
    if max_score is None or max_score < score:
        best_pair = pair
        max_score = score

print(best_pair, max_score)

"""
Çıktı:
('b', '##p') 0.2
"""
Buradan öğrenilecek ilk birleşmenin (“b”, “p”) olduğunu tespit ettik. Bunu sözlüğe ekleyebiliriz.
vocab.append("bp")Devam etmeden önce bu birleşmeyi sözlüğümüze uygulamamız gerekiyor. Bunun içinde kısa bir kod yazalım:
def merge_pair(a, b, splits):
    for word in word_freqs:
        split = splits[word]
        if len(split) == 1:
            continue
        i = 0
        while i < len(split) - 1:
            if split[i] == a and split[i + 1] == b:
                merge = a + b[2:] if b.startswith("##") else a + b
                split = split[:i] + [merge] + split[i + 2 :]
            else:
                i += 1
        splits[word] = split
    return splits
splits = merge_pair("b", "p", splits)
print(splits["bpe"]
"""
Çıktı:
['bp', '##e']
"""Artık genel yapımız ana hatları ile hazır. Bundan sonra ki son aşamada yapılması gereken tek şey, tüm birleştirmeleri öğrenene kadar işlemi yinelemek.
5- Adım: Yineleme
Bu aşamada artık istediğimiz tüm birleştirmeleri öğrenene kadar işlemleri döngüye almamız gerekiyor. Ben bu adımda yineleme (iteration) sayısını 50 olarak verdim. Kodumuz aşağıda:
vocab_size = 50
while len(vocab) < vocab_size:
    scores = compute_pair_scores(splits)
    best_pair, max_score = "", None
    for pair, score in scores.items():
        if max_score is None or max_score < score:
            best_pair = pair
            max_score = score
    splits = merge_pair(*best_pair, splits)
    new_token = (
        best_pair[0] + best_pair[1][2:]
        if best_pair[1].startswith("##")
        else best_pair[0] + best_pair[1]
    )
    vocab.append(new_token)

print(vocab)

"""
Çıktı:
['[PAD]', '[UNK]', '[CLS]', '[SEP]', '[MASK]', '##a', '##b', '##d', '##e', '##g', '##i', '##k', '##l', '##m', '##n', '##o', '##p', '##r', '##s', '##t', '##u', '##y', '##z', '.', 'B', 'U', 'a', 'b', 'e', 'g', 'i', 'n', 'o', 't', 'u', 'v', 'bp', 'eg', 'Bu', 'uy', 'uyg', 'uygu', '##um', 'Um', 'to', 'tok', 'go', '##kt', 'bo', '##yo']
"""
MERGES
37 Adet
VACAB
50 AdetSonuç olarak başlangıçta 37 adet tokenimiz varken 13 adet yeni birleştirme kuralı öğrendik. Böylece 50 kelimeye duyarlı bir tokenizer elde ettik.
Görebildiğimiz gibi, BPE ile karşılaştırıldığında bu tokenizer, kelimelerin bazı kısımlarını token olarak biraz daha hızlı öğreniyor.
Şimdi tokenizer’i sözlükte olan ve olmayan bir kelime üzerinde test edelim:
print(encode_word("bolum"))
print(encode_word("bölum"))

"""
Çıktı:
['bo', '##l', '##um']
['[UNK]']
"""
Gördüğünüz gibi sözlükte olmayan bir karakter veya yeterince birleşme kuralı öğrenmemiş bir tokenizer, kendisine verilen metindeki bazı özellikleri bilmeyecektir. Bu açıdan bir tokenizer modeli geliştirirken geniş bir külliyat ve yeterli bir yineleme oranı oldukça önemlidir. Modele ne kadar çok karakter/kelime tanırsa, ne kadar çok birleştirme kuralını öğrenirse, o kadar iyi sonuçlar verecektir.
Düşünelim? Değerlendirelim?
Google, WordPiece’in eğitim algoritmasının uygulanmasını hiçbir zaman açık kaynaklı hale getirmedi, bu nedenle burada behsettiğimiz açıklamalar ve kullandığımız örnek kodlar literatüre dayalı en iyi tahminlerden yola çıkarak hazırlanmıştır. %100 doğru olmayabilir.
Yazıyı kısaca özetleyelim:
- WordPiece’in öğrenilen birleştirme kurallarını değil, yalnızca son kelimeleri kaydetmesi açısından BPE’e ye göre farklılık gösterir. WordPiece, kelimeyi tokenize etmeye başladığında sözlükteki en uzun alt kelimeyi bulur ve onu böler.
- Belirli bir kelimeyi kodlamanın birden fazla yolu olabilir. Bu durumda belirli bir sembol çifti birleştirilirken her adımda sahip olduğu etkiyi hesaba katmak çok daha iyi performans gösterecektir. WordPiece de tam olarak bunu yapar.
- WordPiece ve BPE arasındaki temel fark, sembol çiftlerini sözlüğe ekleme şekilleridir. BPE bir alt kelimeyi sözlüğe eklerken sözcüğün frekansını hesaba katarken WPC, en yüksek olasılığa sahip sözcük çiftini seçer.
- WordPiece algoritması, sözcükleri daha küçük, daha yönetilebilir alt sözcüklere bölmede oldukça başarılıdır. Bu özelliği onu nadir sözcüklerle ve diğer dil sorunları ile başa çıkmada etkili bir araç haline getirmiştir.
Konuyu gerek edindiğim bilgiler, gerekse de yapmış olduğum araştırmaların sonuçlarını özetleyerek en yalın halde ifade etmeye çalıştım. Umarım faydalı olur.
Uygulama kodlarını (bundan sonra ki süreç içinde geçerli) aşağıda ki github adresi üzerinden paylaşıyorum.
Buraya kadar okuma zahmeti gösterdiğiniz için teşekkür ederim. Bir sonra ki bölümde Unigram tokenizasyon algoritmasını inceleyeceğiz.
Görüşmek üzere..